
 EN
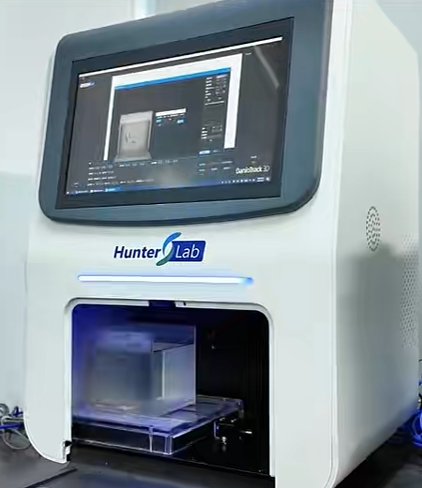
Welke trainingsgegevens zijn nodig om een gedragsanalyse-systeem voor zebravissen te optimaliseren?
AZebrafish gedragsanalyse-systeem kan video omzetten in metingen op het gebied van locomotie, positie en gebeurtenissen, maar de uitvoer is slechts zo betrouwbaar als de data die worden gebruikt voor configuratie en validatie. Voor een farmaceutisch O&O-team is de nuttige vraag niet eenvoudig ‘hoeveel video’s hebben we nodig?’, maar of de trainingsdata de dieren, testomstandigheden, camerabeelden en randgevallen weerspiegelen die het team daadwerkelijk tegenkomt.
De juiste dataset hangt af van de biologische vraag. Een systeem dat is getraind om zwemacties van larven te detecteren in een gecontroleerde plaatassay, is niet automatisch geschikt om sociale afstand bij volwassen vissen of een reactie onder andere verlichtingsomstandigheden te classificeren. Een praktisch optimalisatieplan begint met een schriftelijke dataspecificatie en test vervolgens of het systeem nog steeds logisch gedraagt wanneer alledaagse laboratoriumvariaties optreden.
Begin met de beslissing die het systeem moet ondersteunen
Voordat u meer beeldmateriaal verzamelt, definieert u de beslissing uw Zebrafish gedragsanalyse-systeem wordt verwacht te ondersteunen. Is het een triagebeslissing voor screening, een vergelijking van fenotypen, een beoordeling van toxiciteitssignalen of een studie naar methodologieontwikkeling? Het antwoord bepaalt de labels, de tijdelijke resolutie en de fouttolerantie die van belang zijn.
Een verkennend onderzoek vereist bijvoorbeeld betrouwbare samenvattingen van activiteit en een manier om opnames die nader moeten worden beoordeeld, te markeren. Een bevestigend onderzoek vereist mogelijk traceerbare uitvoer per dier, vooraf gedefinieerde uitsluitingen en een degelijker audittrail. De verborgen kosten in beide werkstromen bestaan vaak uit het opnieuw labelen van dubbelzinnige fragmenten nadat een model al is afgestemd op die fragmenten. Definieer eerst het eindpunt en verzamel vervolgens trainingsdata rond dat eindpunt, in plaats van één model te vragen om elk gedragsvraagstuk op te lossen.
Zorg voor dekking van de biologische bronnen van variatie
Nuttig trainingsdata moet representatieve vissen en experimentele toestanden omvatten, niet alleen de duidelijkste opnames. Noteer het ontwikkelingsstadium, het stam- of lijnnummer indien van toepassing, het legsel of de cohort, het geslacht indien van toepassing, de behandelingsgroep, de voedings- en acclimatisatieomstandigheden en het geplande gedragsparadigma. Deze velden helpen een team later te bepalen of een ogenschijnlijke fout van machine learning eigenlijk een verschuiving in de testpopulatie is.
Neem zowel gewone als moeilijke voorbeelden op: vissen met lage activiteit, snelle bochten, overlappende dieren, gedeeltelijke verduistering, rommel, weerkaatsingen en dieren die zich dicht bij de rand van de arena bevinden. In gepubliceerde zebrafish-onderzoeken is gebruikgemaakt van camera-gebaseerde driedimensionale tracking en herkenning van gedragskenmerken; dat is een herinnering aan het feit dat geometrie en kijkomstandigheden deel uitmaken van de probleemdefinitie, niet slechts een hardware-detail.
Stel tijdens de planning een directe vraag: Hebt u de cohorts en gedragstoestanden bemonsterd die het systeem na implementatie zullen uitdagen? Als het antwoord nee is, voeg dan die clips toe voordat u de eenvoudigste klasse uitbreidt. A Zebrafish gedragsanalyse-systeem een model dat is getraind op een smalle ‘schone’ verdeling, kan accuraat lijken terwijl het mislukt op de opnames die het meest van belang zijn.
Registreer beeldvormings- en assaymetadata bij elke video
Voor optimalisatie , want alleen videobestanden zijn niet voldoende. Koppel elke opname aan de camerapositie, het objectief en de vergroting, het beeldfrequentie, de resolutie, de belichting, de arena-geometrie, de watertemperatuur, de opnametijd, de operator en de software-instellingen. Waar gedrag gevoelig is voor manipulatie of omgeving, documenteer ook de acclimatisatie, de timing van stimuli en de volgorde van opnames.
In een ruwe bewegingstrace kan een geleidelijke drift gedurende een sessie zich manifesteren als een subtiele verschuiving in de basisactiviteit — een teken dat temperatuur, licht of acclimatisatie niet zo consistent zijn gehandhaafd als bedoeld. Wij raden aan om dergelijke metadata te behandelen als modelinvoer voor diagnose, zelfs als ze geen directe kenmerken zijn in de uiteindelijke classificator. Dat maakt het mogelijk om een kwaliteitsprobleem met de data te onderscheiden van een biologisch resultaat.
Richtlijnen voor het rapporteren van methoden bij larvale zebravisassays benadrukken methodologische variabelen, en richtlijnen voor het rapporteren van dierstudies wijzen ook op randomisatie en blindering. Pas dezelfde discipline toe op een Zebrafish gedragsanalyse-systeem : behoud de omstandigheden waaronder labels en uitkomsten zijn gegenereerd.
Ontwerp labels die aansluiten bij de beoogde analyse.
Labelkwaliteit is meestal waardevoller dan een grote hoeveelheid zwak gedefinieerde videoclips. Schrijf een korte annotatiegids waarin elke houding, bewegingsgebeurtenis, zoneovergang of abnormaal gedrag wordt gedefinieerd; voeg voorbeelden toe en een regel voor onzekere gevallen. Gebruik ten minste een bemonsterd dubbel-labelproces en bespreek geschillen met iemand die de assay begrijpt, in plaats van deze uitsluitend op basis van meerderheidsstemming op te lossen.
Voor pose- of trajectorietaak, behoud annotaties uit meer dan één visuele context. Bronnen voor het volgen van larvale zebravisjes omvatten zowel videobeelden van vrij zwemmende als van kop-geïmbedde dieren, wat illustreert waarom de voorbereidingscontext aan de labels moet blijven gekoppeld. Voor een Zebrafish gedragsanalyse-systeem , kan „beweging“ in elke context verschillend visueel bewijs betekenen.
Machine learning kan annotatie en classificatie ondersteunen, maar mag het biologische eindpunt niet stilletjes herdefiniëren. Behoud het menselijke label, de identiteit of rol van de annotator, de annotatieversie en alle geschiedenis van modelondersteunde correcties. Deze gegevens maken latere precies beoordelingen mogelijk.
Splits de gegevens per experiment, niet per bijna identieke frames
Een veelgemaakte fout is om willekeurig frames van dezelfde vis of opname te verdelen over trainings- en testsets. Dat kan een model sterker laten lijken, omdat de testframes sterk lijken op wat het al eerder heeft gezien. Houd in plaats daarvan hele vissen, putjes, opnamesessies of – ideaal – onafhankelijke experimentele runs bij elkaar in één splitsing.
Reserveer een definitieve holdout-set die een toekomstige run weerspiegelt: een andere dag, cohort, operator of gecontroleerde beeldvormingsomstandigheid. Rapporteer vervolgens de prestaties per betekenisvolle subgroep, zoals gedragsklasse, camerasetup, ontwikkelingsfase en assay-batch. Indien een Zebrafish gedragsanalyse-systeem onregelmatig presteert, is het resultaat nuttig: het geeft het team aan waar gerichtere trainingsdata nodig zijn.
Gebruik een iteratieve optimalisatie-loop
- Stel een uitgangsniveau voor de assay vast. Verzamel representatieve controleopnames en documenteer normale variabiliteit voordat het model wordt aangepast.
- Controleer fouten op oorzaak. Gropeer ‘misses’ in categorieën zoals label-ambivalentie, beeldkwaliteit, ongebruikelijk gedrag, hardware-setup of biologische context.
- Voeg gerichte voorbeelden toe. Vergroot de zwakste subgroep in plaats van willekeurig meer voorbeelden van de dominante klasse toe te voegen.
- Valideer opnieuw met onaangetaste data. Vergelijk de nieuwe versie met de vergrendelde holdoutset en behoud de vorige versie als de afweging niet gerechtvaardigd is.
- Versioneer alles. Koppel elke modelversie aan een datasetmanifest, annotatiehandleiding, configuratie en beoordelingsnotities.
Onze eerste instinct kan zijn om de doorvoer zo hoog mogelijk te krijgen, maar ongelijkmatige labels of ongecontroleerde data-acquisitie kunnen het resultaat stilletjes ondermijnen totdat het team vertraagt en de datapipeline standaardiseert. Dat is vaak de meest productieve vorm van optimalisatie .
Een praktische klaarheidchecklist
- Bestrijkt de dataset de vissoorten, gedragingen en beeldvormingsomstandigheden die in het onderzoek worden gebruikt?
- Zijn de metadata en labeldefinities volledig genoeg om elk voorbeeld voor een andere beoordelaar begrijpelijk te maken?
- Zijn de trainings-, validatie- en holdoutsets gescheiden op basis van biologische of experimentele eenheden?
- Heeft een geblindeerde of onafhankelijke beoordelaar een representatief steekproef van labels en uitvoer gecontroleerd?
- Kan het team elk resultaat traceren vanaf de Zebrafish gedragsanalyse-systeem terug naar een model- en datasetversie?
Als meerdere antwoorden ‘nee’ zijn, verzamel beter gerichte bewijsvoering voordat u een complexer model onderzoekt. Een betrouwbare Zebrafish gedragsanalyse-systeem wordt opgebouwd uit representatieve gegevens, transparante labels en validatie die lijkt op het volgende echte experiment—niet alleen op basis van volume.








