
 EN
Un monitoraggio della frequenza cardiaca nel pesce zebra che genera un file CSV ordinato sembra un progresso, finché quel file non deve essere unito a una mappa della piastra, a un timestamp dell’immagine e a un identificativo animale. È qui che molti progetti di integrazione di questo tipo si bloccano. Lo strumento funziona. L’analisi funziona. Il passaggio dei dati no. L’integrazione dati non è una questione di formato file. È una questione di contesto. La domanda più difficile è se i numeri arrivino con un contesto sufficiente per essere considerati affidabili nei processi successivi, senza necessità di collegamenti manuali.
Tre livelli vengono spesso confusi durante l’acquisto.
| Strato | Cosa viene trasmesso | Guasto tipico | Esigenza downstream |
|---|---|---|---|
| Consegna file | CSV o PDF | Le intestazioni variano; nessun fuso orario | Campi stabili, tag fuso orario |
| Collegamento al protocollo | SiLA 2 o OPC UA LADS | L'API privata è un file drop | Funzionalità e stati di errore |
| Collegamento contestuale | ID piastra, pozzetto, ID animale | Nessuna mappatura chiave-piastra | Identificatore condiviso |
Un sistema può apparire integrato al livello uno e fallire al livello tre. Le esportazioni di file sono utili, ma non costituiscono interoperabilità. Trattarle come equivalenti genera lavoro nascosto nell’analisi ad alto contenuto. L’integrazione dei dati deve coprire il passaggio di consegna, non solo l’esportazione.
Dove i dati della frequenza cardiaca rimangono bloccati
Nell’analisi ad alto contenuto, la frequenza cardiaca è uno dei molti parametri. Una piastra per immagini può generare dati in battiti al minuto, intervalli tra i battiti e dati morfologici associati ai pozzetti che contengono il composto e lo stadio sperimentale. Quando il monitor della frequenza cardiaca del pesce zebra opera al di fuori del programma del lettore di piastre, l’esperimento genera flussi paralleli che richiedono una successiva sincronizzazione.
L’allineamento dei timestamp è un punto critico frequente. Un monitor che registra l’ora reale e uno strumento di acquisizione immagini che logga frame relativi all’esecuzione generano uno scostamento che aumenta con ogni pausa. Tale scostamento è gestibile se documentato. Diventa invece dannoso quando rimane invisibile, poiché i modelli successivi trattano le righe unite come un unico riferimento.
La deriva degli identificatori è più silenziosa. La stessa piastra può avere un nome descrittivo nel software di acquisizione, una forma abbreviata nell’esportazione della frequenza cardiaca e una variante con prefisso data nel sistema LIMS. Insieme, questi fattori impongono un passaggio di abbinamento che consuma tempo e aumenta il rischio di trascrizione errata. I sistemi SiLA 2 o OPC UA LADS riducono questo problema esponendo gli identificatori tramite un’interfaccia definita, anziché tramite stringhe di intestazione di colonna. L’integrazione dei dati deve considerare la provenienza come parte integrante del risultato. Un valore di frequenza cardiaca privo di un identificativo della piastra e di un timestamp è un dato, ma non una prova.
Adattare l’integrazione alla scala dello screening
Un piccolo gruppo accademico che esegue poche lastre al mese potrebbe accontentarsi di un’esportazione documentata e di un campo fuso orario. L’aggiunta manuale dei metadati funziona a basso volume, ma la continuità diventa un rischio quando quell’analista lascia l’organizzazione. Una struttura per screening che processa decine di lastre al giorno non può tollerare una riconciliazione manuale. Questo sito trae vantaggio da un monitor della frequenza cardiaca per zebrafish dotato di un’interfaccia programmabile, come un endpoint REST, un insieme di funzionalità SiLA 2 o una coda di messaggi con un identificatore stabile. Una via intermedia consiste nell’esportazione in batch abbinata a un’ingestione automatizzata che convalidi lo schema e scarti i record malformati. Ciò mantiene semplice il passaggio dei file, individuando tuttavia eventuali deviazioni prima che raggiungano il sistema LIMS. Non si tratta di integrazione in tempo reale, ma spesso soddisfa le esigenze di una revisione a fine giornata. Nessun percorso di integrazione dati può risolvere uno studio che non abbia definito fin dall’inizio gli identificatori. Un monitor della frequenza cardiaca per zebrafish non può dedurre che una pozzetta corrisponda a un embrione, a meno che tale relazione non sia già presente in un sistema interrogabile.
Una nota sul campo da un banco di screening
In un nucleo accademico di screening, un flusso di lavoro per la misurazione della frequenza cardiaca nel pesce zebra esportava valori BPM per pozzetto in cartelle contrassegnate dalla data. Il team downstream ha costruito una pipeline intorno a quei file e ha funzionato fintanto che un tecnico ha assegnato nomi alle cartelle in modo coerente.
I problemi sono iniziati quando il nucleo ha aggiunto un secondo sistema di imaging con una disposizione diversa delle piastre. Il nuovo software codificava la posizione del pozzetto come un’unica stringa anziché come campi separati per riga e colonna. Il monitor della frequenza cardiaca nel pesce zebra continuava a generare un formato a due colonne. La pipeline accettava entrambi i formati in silenzio e produceva un dataset unito con alcuni pozzetti allineati in modo errato. Nessun componente era guasto. Il monitor e l’imager effettuavano misurazioni accurate. Il guasto risiedeva tra i sistemi, dove non era mai stato definito un identificatore condiviso.
La soluzione è stata un middleware che normalizzava gli identificatori dei pozzetti e scartava i record non mappabili. Un documento dello schema leggibile da entrambi i fornitori ha reso più semplice l’integrazione del successivo sistema. L’integrazione dei dati dà risultati quando l’identificatore condiviso viene applicato rigorosamente.
Checklist pre-acquisto per l’integrazione
Richiedere lo schema di esportazione, i tag relativi al fuso orario, l'orologio di origine e un'interfaccia a livello di protocollo. Eseguire test sul round-trip degli identificatori con mappe di piastra complesse. L'output deve essere progettato per sistemi, non per un utente che apre Excel.
Dove si inserisce Hunter Lab
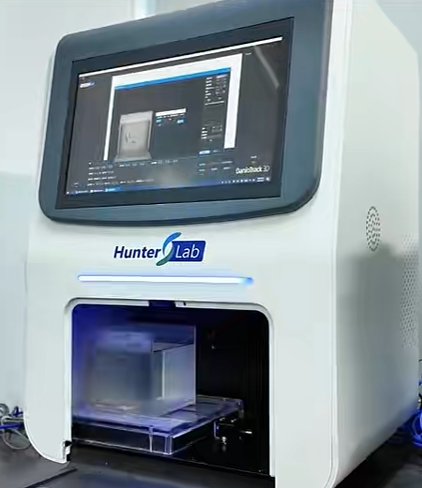
Hunter Lab considera il monitor della frequenza cardiaca del pesce zebra come un singolo nodo in una catena di dati più lunga. L'hardware e il firmware utilizzano contratti di output stabili: denominazione coerente dei campi, timestamp contrassegnati dal fuso orario e formati che mantengono la loro integrità durante il trasferimento verso sistemi LIMS, ELN e pipeline di analisi. Questo approccio deriva dall'esperienza maturata nella produzione e nel controllo qualità, dove anche piccole variazioni di formato diventano costose su larga scala.
L'azienda non impone un'unica architettura per l'integrazione dei dati. La revisione basata su file e uno strato di orchestrazione SiLA 2 presentano vincoli diversi, ma entrambi sono validi. Il contributo consiste nel rendere leggibili i dati provenienti dal monitor della frequenza cardiaca del pesce zebra, documentare onestamente le interfacce e considerare l'interoperabilità come un requisito di prodotto. I laboratori possono fornire autonomamente la propria mappa di piastra e lo schema per valutarne la compatibilità.








